
OCR su PDF scansionato: come rivedere il testo riconosciuto
Trasforma le scansioni in contenuti ricercabili e scopri come trovare errori OCR in nomi, numeri e tabelle.
Il contratto è stato scansionato anni fa e nessuno riesce a trovare una clausola attraverso la ricerca. Sembra contenere testo, ma ogni pagina è una fotografia. Il riconoscimento ottico dei caratteri, noto come OCR, cerca di capire quali lettere esistono nei pixel. È di grande aiuto per la ricerca, ma richiede una revisione quando i dati sono importanti.
L'immagine sorgente decide gran parte del risultato
Pagine storte, ombre sul dorso e timbri sulle parole confondono il riconoscimento. Se è possibile eseguire nuovamente la scansione, allineare il foglio, utilizzare una buona illuminazione ed evitare di ritagliare il bordo. Un'immagine grande non compensa le lettere tremolanti. NodoPDF OCR, inizia con poche pagine e verifica se il risultato mantiene la sequenza dei paragrafi.
Il programma può identificare "0" come "O", "1" come "l" e scambiare virgole per punti. Nei documenti finanziari, una piccola differenza cambia l’intero significato. Cerca termini noti e confrontali con l'immagine della pagina originale prima di copiare i dati.
Il testo ricercabile non è automaticamente testo corretto
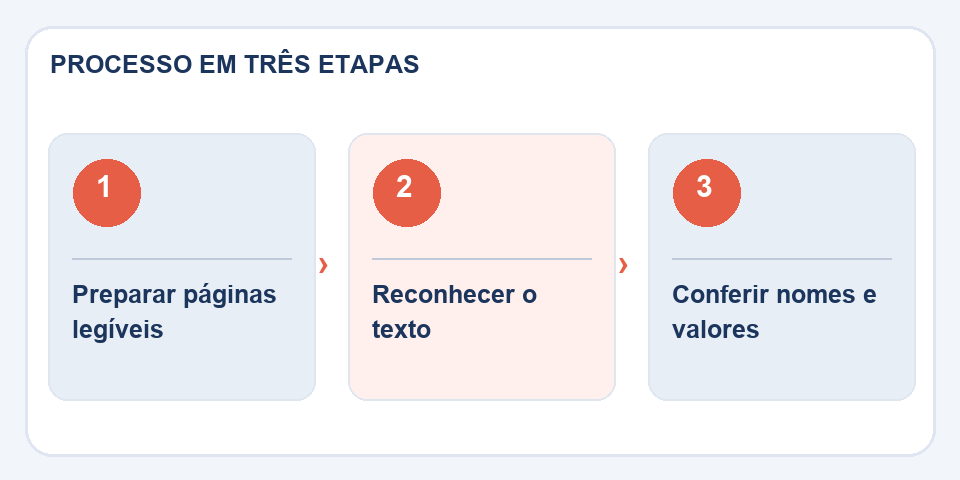
Anche quando l'OCR aggiunge un livello di ricerca al PDF, le tabelle complesse possono risultare difficili da selezionare. Controlla se il testo segue l'ordine delle colonne e se sono state incluse le note a piè di pagina. Per una citazione formale, fare riferimento alla pagina scansionata, non solo al brano riconosciuto.
Cura dei documenti personali
Evitare di condividere materiale inutilmente. Crea una copia funzionante e conserva la scansione originale, poiché consente di controllare le query OCR. L'obiettivo è velocizzare la localizzazione delle informazioni in modo sicuro, mantenendo un riferimento affidabile.
La ricerca aiuta, ma la fonte resta l’immagine
Supponiamo di cercare una clausola in base al nome di un'azienda. L'OCR riconosce quasi tutto, ma cambia una lettera nel nome e la ricerca non restituisce risultati. Ciò non prova che il termine sia assente nel documento. Sulle scansioni più vecchie, sperimenta variazioni di ortografia, sezioni di frasi più brevi e lettura visiva delle pagine più probabili. La tecnologia riduce i tempi di ricerca; non certifica il contenuto.
Quando la scansione presenta timbri, firme, margini scritti a mano o tabelle con numeri, prestare particolare attenzione a questi punti. È opportuno conservare due file identificati: la copia originale e quella con il testo riconosciuto. Se qualcuno ha bisogno di convalidare un valore o una quotazione, l'immagine originale fornisce un riferimento per controllare l'OCR. Per uso legale, contabile o medico, non considerare mai il riconoscimento automatico come una trascrizione infallibile.
Leggi anche
- Come copiare testo da una foto senza introdurre errori nel documento
- Testo copiato da PDF pieno di interruzioni: come renderlo leggibile
- Come numerare le pagine di report e dispense PDF
Riferimento tecnico: struttura delle pagine e ordine di lettura accessibile (W3C).

Fabiano Freitas è laureato in Management dell'Information Technology e scrive di tecnologia applicata alla vita quotidiana, strumenti digitali e produttività. Su FileBito pubblica guide pratiche su PDF, immagini, dati e conversioni, con attenzione alla privacy, alla qualità dei file e al controllo dei risultati.