
OCR på skannad PDF: Hur man granskar igenkänd text
Förvandla skanningar till sökbart innehåll och lär dig hur du hittar OCR-fel i namn, siffror och tabeller.
Kontraktet skannades för flera år sedan och ingen kan hitta en klausul genom sökningen. Det verkar innehålla text, men varje sida är ett fotografi. Optisk teckenigenkänning, känd som OCR, försöker ta reda på vilka bokstäver som finns i pixlar. Det är en stor hjälp för forskning, men kräver revidering när data är viktiga.
Källbilden avgör mycket av resultatet
Krokiga sidor, skuggor på ryggraden och stämplar över ord förvirrar igenkänningen. Om du kan skanna om, rikta in arket, använd bra belysning och undvik att beskära kanten. En stor bild kompenserar inte för skakiga bokstäver. NodPDF OCR, börja med några sidor och se om resultatet bibehåller sekvensen av stycken.
Programmet kan identifiera "0" som "O", "1" som "l" och byta kommatecken mot punkter. I finansiella dokument ändrar en liten skillnad hela innebörden. Sök efter kända termer och jämför med den ursprungliga sidbilden innan du kopierar data.
Sökbar text är inte automatiskt korrekt text
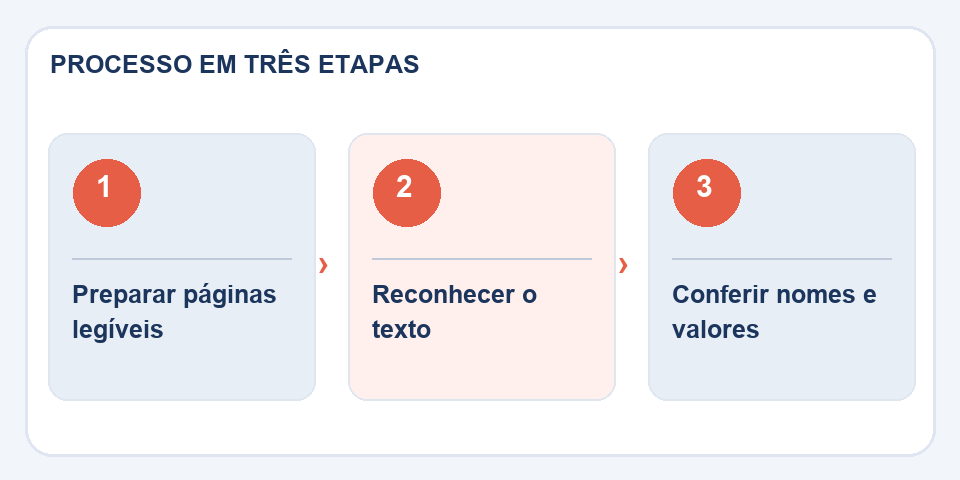
Även när OCR lägger till ett söklager till PDF kan komplexa tabeller förbli svåra att välja. Kontrollera om texten följer kolumnordningen och om fotnoter har tagits med. För en formell hänvisning, se den skannade sidan, inte bara det erkända utdraget.
Vård av personliga handlingar
Undvik att dela material i onödan. Gör en arbetskopia och bevara originalskanningen, eftersom den låter dig kontrollera OCR-frågor. Målet är att snabba upp lokaliseringen av information på ett säkert sätt, och bibehålla en tillförlitlig referens.
Forskning hjälper, men källan förblir bilden
Anta att du söker efter en klausul med namnet på ett företag. OCR känner igen nästan allt, men den ändrar en bokstav i namnet och sökningen ger inga resultat. Detta bevisar inte att termen saknas i dokumentet. På äldre skanningar, experimentera med stavningsvarianter, kortare meningsavsnitt och visuellt läs de mest troliga sidorna. Teknik minskar söktiden; den bekräftar inte innehållet.
När skanningen har stämplar, signaturer, handskrivna marginaler eller tabeller med siffror, var extra uppmärksam på dessa punkter. Det är värt att behålla två identifierade filer: originalkopian och den med igenkänd text. Om någon behöver validera ett värde eller citat ger originalbilden en referens för att kontrollera OCR. För juridiskt, redovisningsmässigt eller medicinskt bruk, behandla aldrig automatisk igenkänning som idiotsäker transkription.
Läs också
- Hur man kopierar text från ett foto utan att införa fel i dokumentet
- Text kopierad från PDF full av pauser: hur man gör den läsbar
- Hur man numrerar sidor i PDF-rapporter och åhörarkopior
Teknisk referens: sidstruktur och tillgänglig läsordning (W3C).

Fabiano Freitas har en examen i Information Technology Management och skriver om teknik tillämpad i vardagen, digitala verktyg och produktivitet. På FileBito publicerar den praktisk vägledning om PDF, bilder, data och konverteringar, med uppmärksamhet på integritet, filkvalitet och kontroll av resultat.