
スキャンした PDF の OCR: 認識されたテキストを確認する方法
スキャンを検索可能なコンテンツに変換し、名前、数値、表の OCR エラーを見つける方法を学びます。
契約書は何年も前にスキャンされたものですが、検索しても条項を見つけることはできません。テキストが含まれているように見えますが、各ページは写真です。 OCR として知られる光学式文字認識は、ピクセル内にどの文字が存在するかを判断しようとします。研究には非常に役立ちますが、データが重要な場合は修正が必要です。
ソース画像が結果の多くを決定します
曲がったページ、背表紙の影、単語の上にスタンプがあると、認識が混乱します。再スキャンできる場合は、シートを位置合わせし、適切な照明を使用し、端が切り取られないようにしてください。画像が大きいと文字の揺れは補正されません。ノードPDF OCR、いくつかのページから始めて、結果が段落の順序を維持しているかどうかを確認します。
プログラムは、「0」を「O」、「1」を「l」として識別し、カンマをピリオドに置き換えることができます。財務書類では、ほんのわずかな違いが全体の意味を変えます。データをコピーする前に、既知の用語を検索し、元のページ画像と比較します。
検索可能なテキストが自動的に正しいテキストになるわけではない
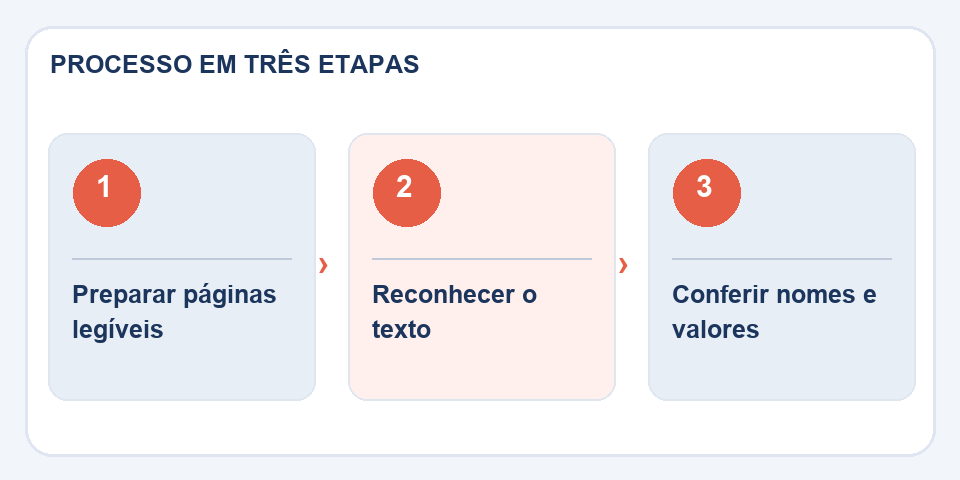
OCR が PDF に検索レイヤーを追加した場合でも、複雑なテーブルの選択は依然として難しい場合があります。テキストが列の順序に従っているか、脚注が含まれているかを確認してください。正式な引用については、認識された抜粋だけでなく、スキャンされたページを参照してください。
個人文書の管理
不必要に資料を共有することは避けてください。作業コピーを作成し、OCR クエリを確認できるように元のスキャンを保存します。目的は、情報の安全な場所の特定を迅速化し、信頼できる参照を維持することです。
研究は役に立ちますが、情報源は画像のままです
会社名で条項を検索するとします。 OCR はほぼすべてを認識しますが、名前の 1 文字が変更され、検索では結果が返されません。これは、その用語が文書に存在しないことを証明するものではありません。古いスキャンでは、スペルのバリエーション、短い文セクション、最も可能性の高いページを視覚的に読み取ることを試してください。テクノロジーにより検索時間が短縮されます。内容を保証するものではありません。
スキャン結果にスタンプ、署名、手書きの余白、番号が記載された表がある場合は、これらの点に特に注意してください。識別された 2 つのファイル、つまり元のコピーと認識されたテキストを含むファイルを保持しておくことは価値があります。誰かが値や引用を検証する必要がある場合、元の画像は OCR をチェックするための参照を提供します。法務、会計、または医療用途では、自動認識を確実な転写として決して扱わないでください。
こちらもお読みください
技術リファレンス: ページ構造とアクセス可能な読み取り順序 (W3C).

Fabiano Freitas は情報技術管理の学位を取得しており、日常生活に適用されるテクノロジー、デジタル ツール、生産性について執筆しています。 FileBito では、プライバシー、ファイルの品質、結果のチェックに配慮した、PDF、画像、データ、変換に関する実践的なガイダンスを公開しています。