
OCR na zeskanowanym pliku PDF: jak sprawdzić rozpoznany tekst
Zamień skany w treść, którą można przeszukiwać i dowiedz się, jak znaleźć błędy OCR w nazwach, liczbach i tabelach.
Umowa została zeskanowana wiele lat temu i w wyszukiwarce nikt nie może znaleźć klauzuli. Wygląda na to, że zawiera tekst, ale każda strona to fotografia. Optyczne rozpoznawanie znaków, znane jako OCR, próbuje dowiedzieć się, które litery występują w pikselach. Jest to ogromna pomoc w badaniach, ale wymaga przeglądu, gdy dane są ważne.
Obraz źródłowy w dużej mierze decyduje o wyniku
Krzywe strony, cienie na grzbiecie i pieczątki nad słowami utrudniają rozpoznanie. Jeśli możesz ponownie zeskanować, wyrównaj arkusz, użyj dobrego oświetlenia i unikaj przycinania krawędzi. Duży obraz nie rekompensuje drżących liter. WęzełPDF-OCR, zacznij od kilku stron i sprawdź, czy w rezultacie zachowana zostanie kolejność akapitów.
Program może identyfikować „0” jako „O”, „1” jako „l” i zamieniać przecinki na kropki. W dokumentach finansowych niewielka różnica zmienia całe znaczenie. Wyszukaj znane terminy i porównaj z oryginalnym obrazem strony przed skopiowaniem danych.
Tekst, który można przeszukiwać, nie jest automatycznie poprawnym tekstem
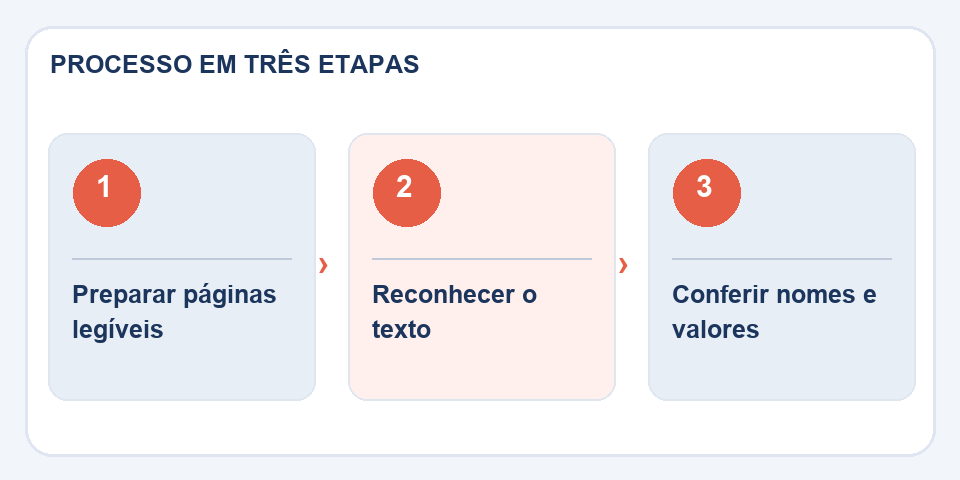
Nawet jeśli OCR doda warstwę wyszukiwania do pliku PDF, wybór złożonych tabel może pozostać trudny. Sprawdź, czy tekst jest zgodny z kolejnością kolumn i czy uwzględniono przypisy. Aby uzyskać formalny cytat, odwołaj się do zeskanowanej strony, a nie tylko do rozpoznanego fragmentu.
Opieka nad dokumentami osobistymi
Unikaj niepotrzebnego udostępniania materiałów. Utwórz kopię roboczą i zachowaj oryginalny skan, ponieważ umożliwia to sprawdzenie zapytań OCR. Celem jest przyspieszenie bezpiecznego lokalizowania informacji, przy zachowaniu wiarygodnego odniesienia.
Badania pomagają, ale źródłem pozostaje obraz
Załóżmy, że szukasz klauzuli według nazwy firmy. OCR rozpoznaje prawie wszystko, ale zmienia jedną literę w nazwie i wyszukiwanie nie zwraca żadnych wyników. Nie oznacza to jednak braku tego terminu w dokumencie. W przypadku starszych skanów eksperymentuj z odmianami pisowni, krótszymi fragmentami zdań i wizualnie czytaj najbardziej prawdopodobne strony. Technologia skraca czas wyszukiwania; nie potwierdza treści.
Jeżeli na skanie znajdują się pieczątki, podpisy, odręczne marginesy lub tabele z numerami, zwróć szczególną uwagę na te punkty. Warto zachować dwa zidentyfikowane pliki: kopię oryginalną i ten z rozpoznanym tekstem. Jeśli ktoś chce zweryfikować wartość lub wycenę, oryginalny obraz zawiera odniesienie do sprawdzenia OCR. Do celów prawnych, księgowych lub medycznych nigdy nie traktuj automatycznego rozpoznawania jako niezawodnej transkrypcji.
Przeczytaj także
- Jak skopiować tekst ze zdjęcia bez wprowadzania błędów do dokumentu
- Tekst skopiowany z pliku PDF pełen przerw: jak sprawić, by był czytelny
- Jak numerować strony raportów i materiałów informacyjnych w formacie PDF
Informacje techniczne: struktura strony i dostępna kolejność czytania (W3C).

Fabiano Freitas posiada dyplom z zarządzania technologiami informatycznymi i pisze o technologii stosowanej w życiu codziennym, narzędziach cyfrowych i produktywności. W FileBito publikuje praktyczne wskazówki dotyczące plików PDF, obrazów, danych i konwersji, zwracając uwagę na prywatność, jakość plików i sprawdzanie wyników.