
OCR trên PDF được quét: Cách xem lại văn bản được nhận dạng
Biến các bản quét thành nội dung có thể tìm kiếm được và tìm hiểu cách tìm lỗi OCR về tên, số và bảng.
Hợp đồng đã được quét từ nhiều năm trước và không ai có thể tìm thấy một điều khoản thông qua việc tìm kiếm. Có vẻ như nó chứa văn bản, nhưng mỗi trang là một bức ảnh. Nhận dạng ký tự quang học, được gọi là OCR, cố gắng tìm ra chữ cái nào tồn tại bằng pixel. Nó giúp ích rất nhiều cho nghiên cứu nhưng cần phải sửa đổi khi dữ liệu quan trọng.
Ảnh nguồn quyết định phần lớn kết quả
Những trang giấy cong queo, những bóng mờ trên gáy và những dấu đóng trên các từ làm cho việc nhận dạng trở nên khó khăn. Nếu bạn có thể quét lại, hãy căn chỉnh trang tính, sử dụng ánh sáng tốt và tránh cắt xén mép. Hình ảnh lớn không bù đắp được chữ bị rung. NútPDF OCR, hãy bắt đầu với một vài trang và xem liệu kết quả có duy trì được trình tự các đoạn văn hay không.
Chương trình có thể xác định “0” là “O”, “1” là “l” và đổi dấu phẩy cho dấu chấm. Trong các tài liệu tài chính, một sự khác biệt nhỏ cũng làm thay đổi toàn bộ ý nghĩa. Tìm kiếm các thuật ngữ đã biết và so sánh với hình ảnh trang gốc trước khi sao chép dữ liệu.
Văn bản có thể tìm kiếm không phải là văn bản tự động sửa
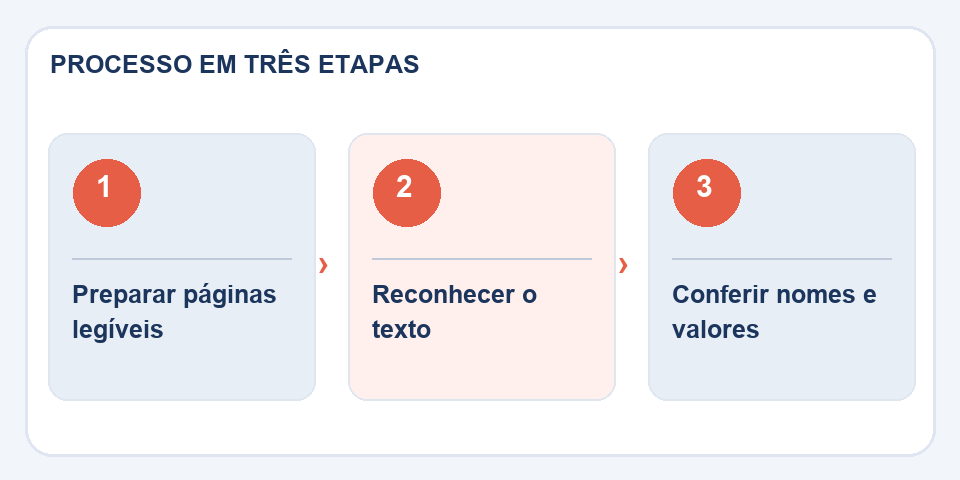
Ngay cả khi OCR thêm lớp tìm kiếm vào PDF, các bảng phức tạp vẫn có thể khó chọn. Kiểm tra xem văn bản có tuân theo thứ tự cột hay không và có bao gồm chú thích cuối trang hay không. Để có trích dẫn chính thức, hãy tham khảo trang được quét chứ không chỉ đoạn trích được công nhận.
Bảo quản giấy tờ cá nhân
Tránh chia sẻ tài liệu một cách không cần thiết. Tạo một bản sao làm việc và giữ nguyên bản quét gốc vì nó cho phép bạn kiểm tra các truy vấn OCR. Mục tiêu là tăng tốc độ định vị thông tin một cách an toàn, duy trì nguồn tham khảo đáng tin cậy.
Nghiên cứu giúp ích, nhưng nguồn vẫn là hình ảnh
Giả sử bạn tìm kiếm một mệnh đề theo tên của một công ty. OCR nhận dạng hầu hết mọi thứ nhưng nó thay đổi một chữ cái trong tên và tìm kiếm không trả lại kết quả nào. Điều này không chứng minh rằng thuật ngữ đó không có trong tài liệu. Trên các bản quét cũ hơn, hãy thử nghiệm các biến thể chính tả, các phần câu ngắn hơn và đọc trực quan các trang có nhiều khả năng nhất. Công nghệ giảm thời gian tìm kiếm; nó không chứng nhận nội dung.
Khi bản scan có tem, chữ ký, lề viết tay hay bảng biểu có số, hãy chú ý thêm những điểm này. Cần lưu giữ hai tệp đã được xác định: bản gốc và tệp có văn bản được nhận dạng. Nếu ai đó cần xác thực một giá trị hoặc báo giá, hình ảnh gốc sẽ cung cấp tham chiếu để kiểm tra OCR. Để sử dụng cho mục đích pháp lý, kế toán hoặc y tế, đừng bao giờ coi tính năng nhận dạng tự động là bản sao chép chắc chắn.
Cũng đọc
- Cách sao chép văn bản từ ảnh mà không gây lỗi vào tài liệu
- Văn bản được sao chép từ PDF đầy dấu ngắt: cách làm cho văn bản có thể đọc được
- Cách đánh số trang báo cáo và tài liệu PDF
Tham khảo kỹ thuật: Cấu trúc trang và thứ tự đọc có thể truy cập (W3C).

Fabiano Freitas có bằng Quản lý Công nghệ Thông tin và viết về công nghệ ứng dụng vào cuộc sống hàng ngày, các công cụ kỹ thuật số và năng suất. Tại FileBito, nó xuất bản hướng dẫn thực tế về PDF, hình ảnh, dữ liệu và chuyển đổi, chú ý đến quyền riêng tư, chất lượng tệp và kiểm tra kết quả.